SEOの無限カレンダーとは?Googlebotが無限URLをクロールする原因と対策
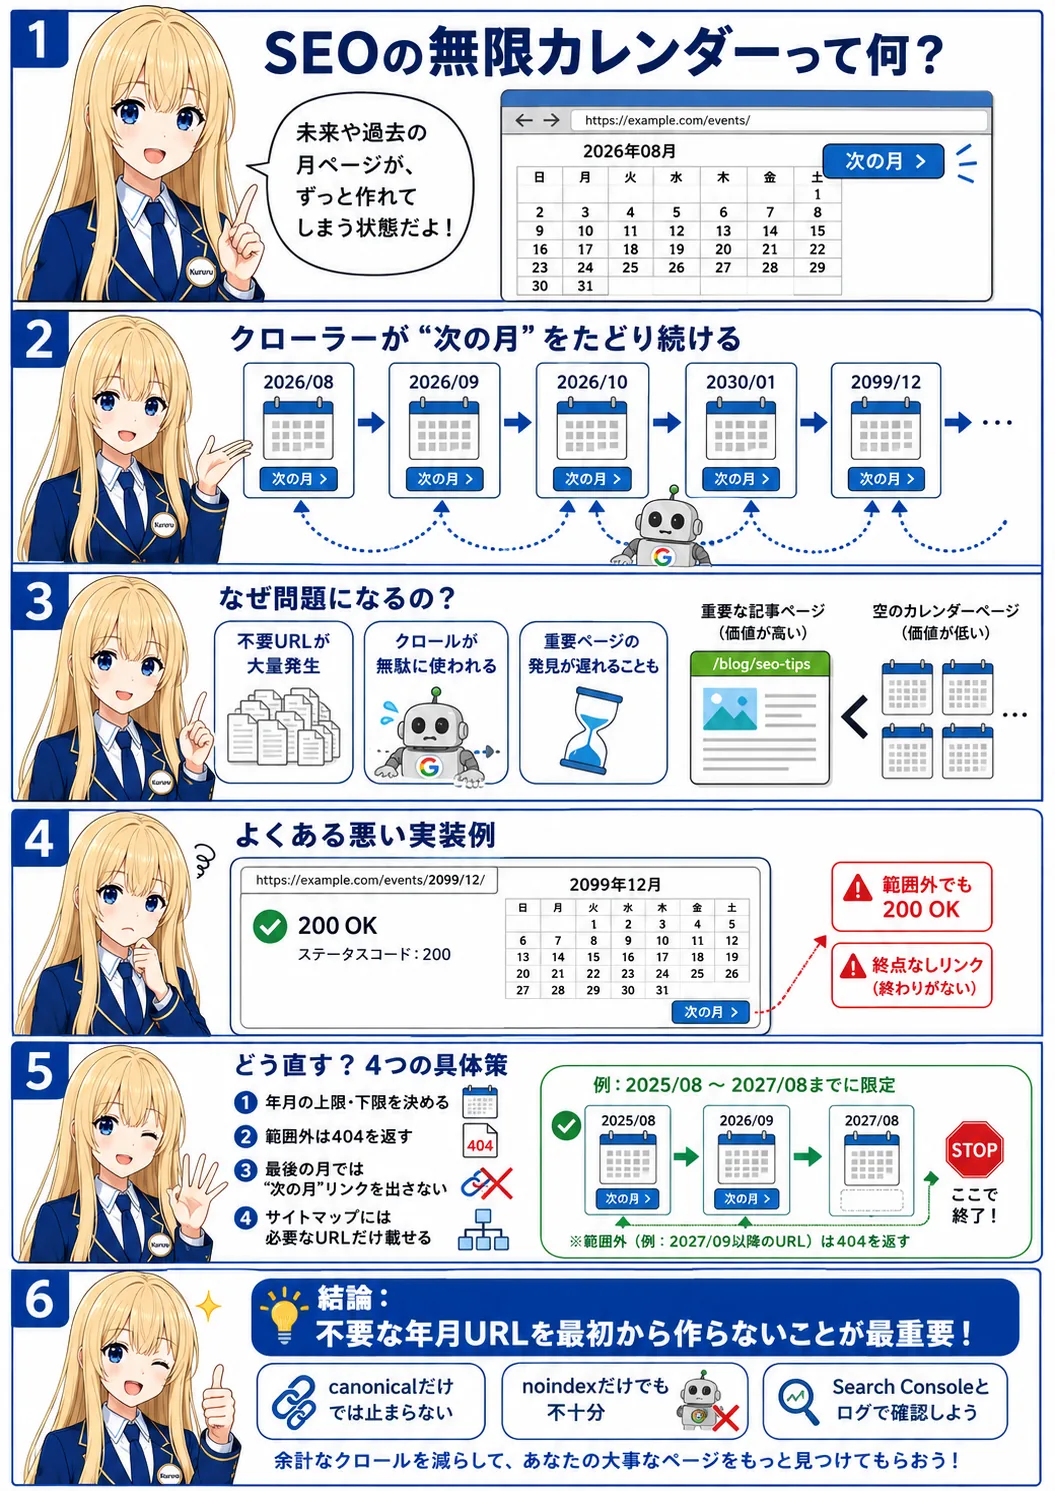
Webサイトにカレンダー機能を実装するとき、意外に見落としやすいSEO問題があります。
それが**無限カレンダー(Infinite Calendar)**です。
例えば、次のようなイベントカレンダーがあるとします。
2026年8月
  ↓ 次の月
2026年9月
  ↓ 次の月
2026年10月
  ↓
2027年1月
  ↓
2030年1月
  ↓
2050年1月
  ↓
2099年1月
  ↓
……
人間は2099年までクリックしません。
しかし検索エンジンのクローラーは、リンクが存在する限りURLを発見できます。
Googleは以前から、「Next Monthを永遠にたどれるカレンダー」そのものを infinite space の代表例として挙げています。現在のGoogle Search CentralのURL構造ガイドでも、無限カレンダーについて明示的な注意があります。
結論・要点
SEOの無限カレンダー対策で最も重要なのは、不要な年月URLを最初から生成・リンクしないことです。
canonical や noindex を後から付けるだけでは、URLそのものの発見やクロールを十分に止められません。
基本方針は次のとおりです。
- カレンダーに有効な年月範囲を設定する。
- 範囲外への「前月」「次月」リンクを生成しない。
- 存在しないページは原則として
404を返す。 - 検索結果に不要だがユーザーには必要な有限ページだけ
noindexを検討する。 - インデックス対象ページには適切な自己参照canonicalを設定する。
- サイトマップには検索価値のあるURLだけを登録する。
- Search Consoleとアクセスログで異常な年月URLがクロールされていないか確認する。
Googleは、多数の低価値URLやinfinite spacesがクロールとインデックス処理に悪影響を与える可能性を説明しています。これは「無限カレンダーが存在しただけで検索順位が下がる」という意味ではありません。ランキングペナルティというより、重要でないURLへクロール資源を使わせる設計上の問題として考えるべきです。
この記事の要点
- 無限カレンダーはGooglebotが未来や過去の年月URLを際限なく発見できる設計である。
- Googleは無限に「次の月」をたどれるカレンダーをinfinite spaceの代表例として挙げている。
- 無限カレンダー対策の中心は不要URLを生成・リンクしないことである。
- canonicalだけでは不要URLのクロール防止にはならない。
- noindexだけではGooglebotによるページ取得そのものを止められない。
- robots.txtだけではURLを検索結果から確実に削除できない。
- 存在しない未来年月ページが200 OKを返し続ける設計は避けるべきである。
- Search ConsoleとWebサーバーログを組み合わせると無限カレンダーを発見しやすい。
- 小規模サイトではクロールバジェットを過度に恐れる必要はない。
- SEO対策ではカレンダーのURL空間そのものを有限に設計することが重要である。
この記事で分かること
この記事では、次の内容を扱います。
- SEOにおける無限カレンダーとは何か
- なぜ検索エンジンが大量の年月URLを発見するのか
- SEOへどのような影響があるのか
- 自分のサイトが無限カレンダーになっているか確認する方法
robots.txt、noindex、canonicalの違い- Djangoで年月URLを制限する実装方法
- 404、410、200をどう使い分けるか
- Search Consoleを使った修正後の確認方法
- 再発を防ぐURL設計
対象読者・前提環境
主な対象読者は次のとおりです。
- Djangoなどでイベントカレンダーを実装している人
- WordPressやCMSにイベント一覧を持っている人
- SEO担当者
- Webサイト運営者
- Googlebotのクロール量が不自然に多いサイトを調査している人
- Search Consoleで大量の不要URLを発見した人
具体例ではDjangoを使用しますが、問題の本質はフレームワークに依存しません。
用語と全体像
無限カレンダーとは
簡単なたとえから考えてみます。
一本道に、
次へというドアが置かれているとします。
ドアを開けると、また同じように「次へ」というドアがあります。
現在
 ↓
次へ
 ↓
次へ
 ↓
次へ
 ↓
次へ
 ↓
終点なし
Webサイトでは、このドアがリンクです。
例えば、
/events/2026/08/
/events/2026/09/
/events/2026/10/
/events/2026/11/
というURLがあり、
<a href="/events/2026/09/">次の月</a>を毎月生成するとします。
2099年になっても同じ処理を続けられる実装なら、
/events/2099/12/までURLを作れてしまいます。
さらに上限がなければ、
/events/9999/12/のようなURLまで理論上到達できる場合があります。
Googleは、このような際限なくURLが増える領域を infinite space と表現しています。カレンダーはGoogle公式文書でも典型例として使われています。
何が起きるのか
通常のカレンダーを考えます。
flowchart LR
    A[2026年8月] --> B[2026年9月]
    B --> C[2026年10月]
    C --> D[2026年11月]
ここまでは問題ありません。
問題になるのは終点がない場合です。
flowchart LR
    A[2026年8月] --> B[2026年9月]
    B --> C[2027年]
    C --> D[2030年]
    D --> E[2050年]
    E --> F[2099年]
    F --> G[さらに未来]
Googlebotから見ると、
リンクを発見
    ↓
URLを取得
    ↓
ページ内で次の月を発見
    ↓
URLを取得
    ↓
さらに次の月を発見
というURL発見ループが成立します。
GoogleはURL構造の公式ガイドで、動的カレンダーが開始日や終了日の制限なしに未来・過去へのリンクを生成する問題を説明しています。
自分のサイトに関係するか
次の構造がある場合は確認する価値があります。
/calendar/2026/08/
/calendar/2026/09/

/events/2026/08/
/events/2026/09/

/schedule/?year=2026&month=8
/schedule/?year=2026&month=9
特に注意したいのは、
year
month
day
page
offset
date
start
end
などをURLから自由に指定できるページです。
例えば、
/events/?year=2099&month=12へアクセスして、
HTTP/2 200が返り、
さらに、
次の月 → 2100年1月まで表示されるなら、典型的な無限カレンダー候補です。
原因
原因1:年月に上限・下限がない
最も基本的な原因です。
例えばDjango側で、
year = request.GET.get("year")
month = request.GET.get("month")
だけを取得し、年月範囲を検証していない場合です。
URLとして解釈できれば、どの年月でも200を返してしまいます。
原因2:「次の月」を必ず生成している
テンプレートが、
<a href="{{ next_month_url }}">次の月</a>を無条件に出力している場合があります。
現在2026年でも、
2030
2050
2099
まで連鎖できます。
原因3:イベントが存在しなくても200 OKになる
例えば2099年12月にイベントが存在しないにもかかわらず、
HTTP/2 200 OKとして、
2099年12月のイベント

イベントはありません。
だけを表示する設計です。
実質的に存在しないコンテンツへ200を返している場合、ページ群が低価値・重複的になり、状況によってはsoft 404として扱われる可能性もあります。
Googleは、本来存在しないページについて200を返すsoft 404を避け、適切な404を返すよう案内しています。
無限カレンダーはSEOペナルティなのか
ここは誤解しやすいポイントです。
無限カレンダーがあるだけでGoogleから手動ペナルティを受ける、という話ではありません。
主な問題は、
重要な記事
重要な商品ページ
重要なカテゴリ
        ↓
Googlebotに発見してほしい

しかし

空の2039年カレンダー
空の2040年カレンダー
空の2041年カレンダー
……
        ↓
大量に存在
という状態になることです。
Googleは多数の低価値URLについて、クロールやインデックス処理へ悪影響を与える可能性を説明しています。
ただし、過度に恐れる必要もありません。
Google Search Consoleの公式ヘルプでは、およそ1,000ページ未満のサイトではクロール統計を細かく心配する必要は通常ないと案内されています。
したがって、
無限カレンダー発見
    ↓
SEOが終わった
ではありません。
正しくは、
無限URLが存在
    ↓
不要クロール・重複URLが増える可能性
    ↓
URL設計を修正する
です。
確認方法
確認1:遠い未来のURLへアクセスする
目的
カレンダーURLに年月の上限が存在するか確認します。
実行場所
Linux、macOS、Windows WSLなどのターミナルです。
コマンド
curl -I https://example.com/events/2099/12/正常例
2099年のページを提供する理由がないサイトなら、
HTTP/2 404などになります。
異常例
HTTP/2 200
content-type: text/html
となり、2099年の空カレンダーが普通に表示されます。
判断方法
さらに2099年12月から、
2100年1月へのリンクが生成されているなら、無限カレンダーである可能性が非常に高くなります。
確認2:HTMLに次月リンクが存在するか確認する
目的
遠い年月でも「次へ」が生成され続けていないか確認します。
実行場所
ターミナルです。
コマンド
curl -s https://example.com/events/2099/12/ | grep -iE 'next|次の月|2100'正常例
出力なしまたはページ自体が404です。
異常例
<a href="/events/2100/01/">次の月</a>判断方法
範囲外のページからさらに範囲外へのリンクが発生している場合、URL空間が閉じられていません。
確認3:Nginxアクセスログを見る
目的
実際に不要な年月URLがアクセスされていないか確認します。
実行場所
Nginxサーバーです。
コマンド
grep 'GET /events/' /var/log/nginx/access.log \
  | awk '{print $7}' \
  | sort \
  | uniq -c \
  | sort -nr \
  | head -50
正常例
/events/2026/08/
/events/2026/09/
/events/2026/07/
など、実際に意味のある年月に集中しています。
異常例
/events/2039/01/
/events/2040/01/
/events/2055/06/
/events/2099/12/
などが大量に登場します。
判断方法
サイトの提供対象期間から明らかに外れた年月が多数存在するなら、生成URLまたは外部リンクを調査します。
確認4:Google Search Consoleを見る
Search Consoleでは主に、
設定
 ↓
クロールの統計情報
を確認できます。
Google公式では、このレポートからGooglebotのリクエスト数、レスポンス状況、サーバー応答などを確認できます。
さらに、
インデックス作成
 ↓
ページ
から、Googleが検出・クロール・インデックスしたURLの状況を確認できます。
例えば、
クロール済み - インデックス未登録などに大量の年月URLが現れている場合は調査対象になります。
ただし、Search Consoleの数値だけで原因を断定せず、Nginxなどのアクセスログと照合する方が確実です。
対処方法
対策1:URL空間を有限にする
最優先です。
例えば、
過去24か月
     ↓
現在
     ↓
未来12か月
だけをカレンダーとして提供します。
2024年8月 ← 最古
    …
2026年8月 ← 現在
    …
2027年8月 ← 最遠
2027年8月では、
次の月というリンク自体を生成しません。
これならクローラーから見ても、
終点ありになります。
Djangoで年月を制限する
例えば次のようにします。
from django.http import Http404
from django.utils import timezone


PAST_MONTH_LIMIT = 24
FUTURE_MONTH_LIMIT = 12


def month_number(year: int, month: int) -> int:
    return year * 12 + month


def event_calendar(request, year: int, month: int):
    if month < 1 or month > 12:
        raise Http404

    today = timezone.localdate()

    current = month_number(today.year, today.month)
    target = month_number(year, month)

    minimum = current - PAST_MONTH_LIMIT
    maximum = current + FUTURE_MONTH_LIMIT

    if target < minimum or target > maximum:
        raise Http404

    # ここから通常のイベント取得処理
重要なのは、
if target < minimum or target > maximum:
    raise Http404
です。
URLルーターが年月を受け付けられるだけでは不十分です。
アプリケーション側で「提供する年月」の境界を決めます。
対策2:範囲外へのリンクを生成しない
404だけでも防御にはなりますが、もっと重要なのはクローラーへURLを発見させないことです。
悪い例です。
<a href="/events/2027/09/">次の月</a>2027年8月が最終ページなら、次月リンクを出しません。
Djangoテンプレートなら、
{% if next_month_url %}
<a href="{{ next_month_url }}">次の月</a>
{% endif %}
のようにします。
理想は、
2027年7月
   ↓
2027年8月
   ↓
終了
です。
nofollowは使うべきか
GoogleのURL構造ガイドでは、無限カレンダーについて、動的に生成される未来カレンダーへのリンクへ nofollow を付ける方法が案内されています。
例えば、
<a href="/events/2028/01/" rel="nofollow">
    次の月
</a>
です。
ただし、アプリケーションを自由に修正できるなら、
不要URLへのリンクを生成しない方が設計として明快です。
つまり、
リンクを作る
+
nofollow
より、
不要ならリンク自体を作らないを基本にします。
robots.txtは使うべきか
robots.txtはクロール制御の仕組みです。
Googleもinfinite spacesについて、必要に応じてrobots.txtでクロールをブロックすることを案内しています。
しかし重要な制約があります。
robots.txtは、
クロールしないでくださいという指示です。
検索結果へ絶対に載せないでくださいという指示ではありません。
Googleはrobots.txtでブロックされたURLでも、外部リンクなどからURLを認識している場合、内容を取得せずURLだけが検索結果へ現れる可能性があると説明しています。
したがって、
robots.txtだけ入れれば全部解決ではありません。
noindexは使うべきか
例えばユーザーには必要だが、検索結果には不要な有限カレンダーがあります。
その場合は、
<meta name="robots" content="noindex">を検討できます。
Googlebotがこの指定を取得すると、そのページはGoogle検索のインデックスから除外されます。
ただし、
noindex = クロール禁止ではありません。
Googlebotはnoindexを確認するためにページへアクセスする必要があります。
さらにrobots.txtでページをブロックすると、Googlebotがnoindexそのものを取得できません。Googleもこの組み合わせについて注意しています。
したがって、
robots.txt
+
noindex
を意味もなく重ねるのは避けます。
canonicalは使うべきか
canonicalは、
似たページが複数あるとき、
どのURLを代表URLとして扱ってほしいか
を検索エンジンへ伝える仕組みです。
例えば、
<link
  rel="canonical"
  href="https://example.com/events/2026/08/"
>
です。
しかし、
/events/2050/01/
      ↓ canonical
/events/
とすれば無限カレンダーが解決するわけではありません。
GoogleはcanonicalをURL正規化のシグナルとして扱いますが、クロール停止命令ではありません。
無限にURLを生成した後でcanonicalを付けるより、
URL自体を生成しない方が先です。
404と410はどう使い分けるか
404
現在存在しないページなら、
404 Not Foundが基本です。
例えば、
/events/2099/12/を現在提供していないなら404で問題ありません。
将来2099年になってページが必要になれば、その時点で200を返せます。
410
410 Goneは、
以前存在したが、
今後復活させない
という意味を明確にしたい場合に向いています。
したがって、
未来だから410という使い方は適切ではありません。
未来の年月は、将来有効になる可能性があるからです。
空の月は404にするべきか
これはサイトの目的で変わります。
イベントが存在する月だけページとして成立するサイト
2026年8月 → イベントあり → 200
2026年9月 → イベントなし → 404
という構成で問題ありません。
空のカレンダー自体をユーザーに見せる必要があるサイト
例えば予約システムなら、
イベントなしという情報自体に意味があります。
この場合は、
200 OKを返しても構いません。
ただし、
2000年~9999年まで全部200にする必要はありません。
有限範囲に制限します。
検索結果へ出す意味がない空ページならnoindexも検討できます。
Sitemapにも不要URLを入れない
サイトマップには、Googleにインデックスしてほしい主要URLだけを登録します。
例えば、
<url>
  <loc>https://example.com/events/2026/08/</loc>
</url>
はイベント情報が存在するなら問題ありません。
一方、
/events/2027/01/
/events/2027/02/
/events/2027/03/
...
を機械的に何年分もサイトマップへ生成する設計は避けます。
canonicalやサイトマップはGoogleによる正規URL選択のシグナルになりますが、サイトマップ指定はcanonicalより弱いシグナルです。
推奨構成
イベントサイトなら、次のようにすると管理しやすくなります。
/events/
    │
    ├── /events/2026/07/
    │
    ├── /events/2026/08/
    │
    ├── /events/2026/09/
    │
    └── /events/2026/10/
そして、
イベント一覧ページ
        ↓
有効な年月だけリンク
        ↓
年月ページ
        ↓
イベント詳細
という構造にします。
逆に、
年月ページ
   ↓
必ず前月
   ↓
必ず次月
   ↓
終了なし
というURLグラフを作らないことが重要です。
動作確認
修正後は、最低でも次を確認します。
現在月
コマンド
curl -I https://example.com/events/2026/08/正常例
HTTP/2 200許可された未来月
コマンド
curl -I https://example.com/events/2027/01/正常例
HTTP/2 200サイトの公開期間内なら問題ありません。
範囲外
コマンド
curl -I https://example.com/events/2099/12/正常例
HTTP/2 404HTMLリンク
コマンド
curl -s https://example.com/events/2027/08/ \
  | grep -i '2027/09'
正常例
出力なし異常例
<a href="/events/2027/09/">次の月</a>再発防止
無限カレンダーはテンプレート修正だけでなく、アプリケーション仕様として防ぐ方が安全です。
例えばテストを追加します。
from django.test import TestCase


class EventCalendarSeoTests(TestCase):

    def test_far_future_calendar_returns_404(self):
        response = self.client.get("/events/2099/12/")
        self.assertEqual(response.status_code, 404)

    def test_invalid_month_returns_404(self):
        response = self.client.get("/events/2026/13/")
        self.assertEqual(response.status_code, 404)
これにより将来コードを変更しても、
2099年が突然200になるような回帰をCIで検出できます。
さらに強くするならリンク境界もテストする
def test_last_available_month_has_no_next_month_link(self):
    response = self.client.get("/events/2027/08/")

    self.assertNotContains(
        response,
        "/events/2027/09/"
    )
SEOは設定ファイルだけの問題ではありません。
URL生成ロジックそのものをテスト対象にすると再発しにくくなります。
注意点・よくある誤解
誤解1:canonicalを入れれば全部解決する
おすすめしません。
canonicalは正規URL選択のシグナルであって、クロール禁止機能ではありません。
誤解2:全部noindexにすればよい
おすすめしません。
noindexを読み取るためにはGooglebotがページをクロールする必要があります。
URLを無限生成してから全部noindexにするのは、原因を残したまま症状だけ処理している状態です。
誤解3:robots.txtだけで消せる
おすすめしません。
robots.txtは主にクロール制御です。
robots.txtでブロックしただけでは、そのURLがGoogleから完全に認識されなくなるとは限りません。
誤解4:すべての空カレンダーは404にすべき
これも一律には言えません。
予約状況など、
この月には予定がありませんという状態そのものにユーザー価値がある場合があります。
重要なのは、
空ページかどうかではなく、
ユーザーに必要か
検索結果に必要か
URL空間が有限か
です。
誤解5:クロールバジェットを1リクエストでも無駄にしてはいけない
過剰反応です。
Google自身も小規模サイトではクロール統計を細かく心配する必要は通常ないと説明しています。
数十個のカレンダーページが存在するだけで重大なSEO障害になるわけではありません。
問題なのは、
数百
数千
数万
数十万
と不要URLが機械的に増え続ける構造です。
SEOの無限カレンダー対策を一言で表すと
悪い設計

現在
 ↓
次月
 ↓
次月
 ↓
次月
 ↓
∞
ではなく、
良い設計

開始
 ↓
有効な月
 ↓
現在
 ↓
有効な未来
 ↓
終了
です。
SEOテクニック以前に、URL空間を有限集合として設計することが重要です。
まとめ
SEOの無限カレンダーは、イベントサイトや予約サイトで起こりやすいクロール設計上の問題です。
Googleは無限に「Next Month」をたどれるカレンダーをinfinite spaceの典型例として公式に取り上げています。
対策の優先順位は、
不要URLを作らない
        ↓
不要URLへリンクしない
        ↓
範囲外は404
        ↓
必要に応じてnofollow
        ↓
検索不要ページはnoindexを検討
        ↓
canonicalを正しく設定
        ↓
サイトマップを整理
        ↓
Search Consoleとログで監視
です。
robots.txt、noindex、canonical は便利ですが、目的がそれぞれ異なります。
最も重要なのは、
無限URLを生成する設計そのものを修正することです。
FAQ
Q1. 無限カレンダーがあるとGoogleからペナルティを受けますか?
無限カレンダーだけを理由とした「ペナルティ」と考えるのは適切ではありません。
主な問題は、低価値なURLが大量に生成されることで、Googlebotのクロールやインデックス処理を非効率にする可能性があることです。
Q2. 2099年のカレンダーは404にしてよいですか?
現在そのページを提供する理由がなければ404で構いません。
将来その年月になってページが必要になれば、その時点で200を返せます。
Q3. 410の方がSEOに強いですか?
単純に410へ変更すればSEOが改善するわけではありません。
410は「今後戻らないページ」に使う意味を持ちます。
将来有効になる可能性がある年月URLへ機械的に410を返す必要はありません。
Q4. noindexとrobots.txtを同時に使えば完璧ですか?
いいえ。
robots.txtでGooglebotをブロックすると、Googlebotがページ内のnoindexを確認できません。Googleもこの点を公式に注意しています。
Q5. canonicalを/events/へ向ければよいですか?
無限カレンダー対策としては不十分です。
canonicalは重複・類似URLの代表ページを指定するためのシグナルです。無限URL生成を止める機能ではありません。
Q6. Googlebotが本当にアクセスしているか確認するには?
Search Consoleのクロール統計とWebサーバーのアクセスログを確認します。
なおUser-Agentの文字列だけではGooglebotを偽装できるため、本物のGooglebotか厳密に確認する場合はGoogle公式が案内しているIP範囲や逆引き確認を利用します。
参考情報
Google Search Central:URL Structure Best Practices
無限カレンダーに関する現在のGoogle公式ガイドです。
URL:
https://developers.google.com/search/docs/crawling-indexing/url-structure
Google Search Central:To infinity and beyond? No!
カレンダーをinfinite spaceの代表例として説明しているGoogle公式記事です。
URL:
https://developers.google.com/search/blog/2008/08/to-infinity-and-beyond-no
Google Search Central:Troubleshoot Crawling Errors
infinite spaces、soft 404、重複コンテンツなどクロール上の問題を整理した公式文書です。
URL:
https://developers.google.com/search/docs/crawling-indexing/troubleshoot-crawling-errors
Google Search Central:What Crawl Budget Means for Googlebot
低価値URL、重複URL、infinite spacesとクロールの関係について説明されています。
URL:
https://developers.google.com/search/blog/2017/01/what-crawl-budget-means-for-googlebot
Google Search Central:noindex
URL:
https://developers.google.com/search/docs/crawling-indexing/block-indexing
Google Search Central:Canonical
URL:
https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls
Google Search Central:robots.txt
URL:
https://developers.google.com/search/docs/crawling-indexing/robots/intro
Google Search Console:クロールの統計情報レポート
URL:
https://support.google.com/webmasters/answer/9679690?hl=ja
Google Search Console:ページ インデックス登録レポート
URL:
https://support.google.com/webmasters/answer/7440203?hl=ja
コメント(0件)
まだコメントはありません。最初のコメントを投稿してください!