情報量の解説(基本情報技術者シラバス用語)
情報量とは 情報量(じょうほうりょう)とは、ある出来事や情報が「どれくらい珍しいか(予測しにくいか)」を数値で表した尺度です。統計や情報の理論において、めったに起こらない珍しい出来事を知ることほど「価値が高い(情報量が多い)」と捉え、逆に当たり前のわかりきったことについては「情報量が少ない(またはゼロ)」とみなします。この情報量を測定する基本的な単位が「ビット(bit)」であり、すべての情報を0か...
Django、Python、AWS、Linux、セキュリティ、CVE、基本情報技術者、応用情報技術者、ITパスポートの用語を、図解と実務手順で解説します。個人開発kurutann.comの検証記録や障害対応事例も公開しています。
タグ「情報に関する理論」の記事を表示中× クリア
情報量とは 情報量(じょうほうりょう)とは、ある出来事や情報が「どれくらい珍しいか(予測しにくいか)」を数値で表した尺度です。統計や情報の理論において、めったに起こらない珍しい出来事を知ることほど「価値が高い(情報量が多い)」と捉え、逆に当たり前のわかりきったことについては「情報量が少ない(またはゼロ)」とみなします。この情報量を測定する基本的な単位が「ビット(bit)」であり、すべての情報を0か...
符号化とは 符号化(ふごうか)とは、人間が理解できる文字、画像、音声などのデータを、コンピュータが処理・通信しやすいように、特定のルールに基づいて「0」と「1」のデジタル信号(コード)に変換することです。「エンコード」とも呼ばれます。逆に、変換されたデジタルデータを人間が読める元の形式に戻すことを「復号(デコード)」と呼びます。インターネットでメールを送る、動画を見る、音楽を聴くといったすべての操...
ハフマン符号とは ハフマン符号(はふまんふごう)とは、データを効率よく圧縮するために開発された符号化の手法です。データの中で「よく使われる(出現頻度が高い)文字」には短いビット(短い0と1の組み合わせ)を割り当て、逆に「めったに使われない文字」には長いビットを割り当てることで、データ全体の合計サイズを最も小さく抑えることができます。この方法を使うと、文字ごとの長さを一律にするよりも大幅にデータサイ...
シャノンの定理とは シャノンの定理(しゃのんのていり)とは、通信回線の性能やノイズの多さに応じて、「その回線を使って、どれだけのデータを誤りなく送ることができるか」という限界値(最大通信速度)を数学的に証明した定理です。「通信路符号化定理」とも呼ばれます。どれほど優れた技術を使っても、ノイズ(雑音)が存在する回線においては、この定理が示す限界のスピード(通信容量)を超えてデータを完璧に送ることはで...
オートマトンとは オートマトン(おーとまとん)とは、あらかじめ決められた「状態」を持ち、外部から「入力(何らかのアクション)」を受けると、そのルールに従って「次の状態」へと遷移(変化)していく、自動的に動作する仕組みや概念モデルのことです。日本語では「自動機械」とも呼ばれます。複雑なコンピュータのプログラムやハードウェアをそのまま設計すると混乱しやすいため、「今どの状態で、何が起きたらどうなるか」...
形式言語とは 形式言語(けいしきげんご)とは、あらかじめ厳密に定められた文法ルールと記号のみを使って構成される言語のことです。私たちが普段使っている日本語や英語のような「自然言語」は、文脈によって意味が変わったり曖昧さがあったりしますが、形式言語にはそのような曖昧さは一切ありません。ルール通りであれば誰が読んでも、コンピュータが読んでも、ただ1つの意味として正しく解釈されます。プログラミング言語(...
逆ポーランド記法とは 逆ポーランド記法(ぎゃくぽーらんどきほう)とは、数式を書くときに、演算子(+やーなどの記号)を数値の「後ろ」に配置する書き方のことです。「後置記法」とも呼ばれます。私たちが普段使っている「3 + 4」のような書き方は「中置記法」と呼ばれ、演算子が数値の間にあります。これに対して逆ポーランド記法では「3 4 +」と書きます。この書き方の最大のメリットは、カッコ「( )」を使わな...
文字コードとは 文字コード(もじこーど)とは、コンピュータで文字を扱うために、1つひとつの文字に対して割り当てられた固有の「識別番号」のルールのことです。コンピュータは「0」と「1」の数値しか理解できないため、文字を画面に表示したり保存したりするには、すべての文字を数値に置き換える必要があります。この置き換えルールのことを文字コードと呼びます。代表的な規格には、英語圏の基本である「ASCII」、世...
AIとはAI(Artificial Intelligence:人工知能)とは、人間の知的な振る舞い(学習、推論、判断、問題解決など)をコンピュータのソフトウェアやシステムを用いて再現する技術のことです。コンピュータが大量のデータを処理し、パターンを見つけ出すことで、人間のように自ら学んで賢くなっていく仕組みを含みます。近年ではスマートフォンの音声アシスタントや、自動翻訳、画像認識など、日常生活のい...
ディープラーニングとはディープラーニング(Deep Learning:深層学習)とは、人間の脳にある神経細胞(ニューロン)のネットワークを模した「ニューラルネットワーク」を何層にも深く重ねて用いることで、コンピュータに複雑なデータを認識・分析させる技術です。従来の機械学習とは異なり、人間が「どの特徴に注目すべきか」を細かく指示しなくても、コンピュータ自身がデータの中から重要な特徴を自動的に見つけ出...
教師あり学習とは教師あり学習(Supervised Learning)とは、コンピュータによる機械学習の手法の一つで、「問題(入力データ)」と「正解(ラベル)」がセットになった学習データ(教師データ)を事前に大量に与えて学習させる方式です。コンピュータは問題と正解のパターンやルールを学び、それをもとに新しい「問題」だけを与えられたときにも、正しい「正解」を予測・判別できるようになります。画像認識や...
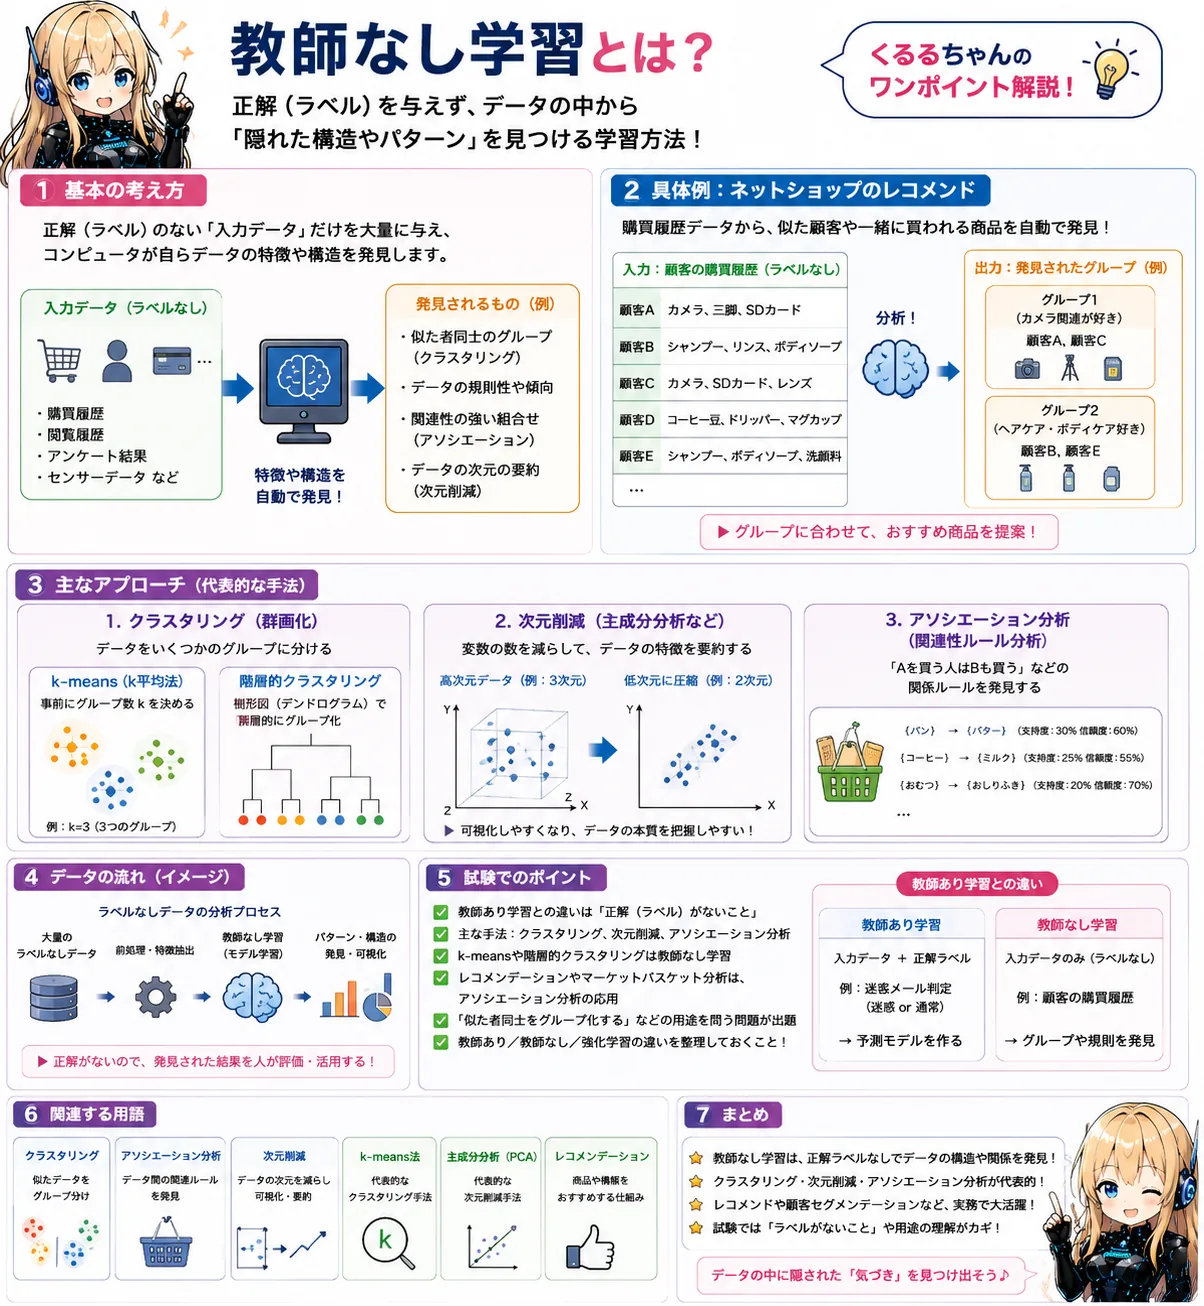
教師なし学習とは教師なし学習(Unsupervised Learning)とは、コンピュータに「正解(ラベル)」を与えず、「問題(入力データ)」だけを大量に与えて学習させる手法です。コンピュータはデータそのものが持つ特徴や構造を自ら分析し、似た者同士をグループに分ける(クラスタリング)ことや、データの規則性を発見することを行います。まだ正解がわかっていないデータの分析や、隠れた関係性を見つけるのに...
強化学習とは強化学習(Reinforcement Learning)とは、コンピュータ(エージェント)が特定の環境のなかで「どのような行動をとるべきか」を試行錯誤を通じて自ら学習する手法です。コンピュータが良い結果を出したときには「報酬(プラスの点数)」を、悪い結果のときには「ペナルティ(マイナスの点数)」を与えることで、得られる報酬の合計が最大になるような最適な行動パターンを自発的に学習していき...
生成AIとは生成AI(Generative AI)とは、大量のデータを学習した人工知能が、人間の指示(プロンプト)に応じて、テキスト、画像、音楽、動画、プログラムのソースコードなど、新しいコンテンツを自動的に作り出す技術です。従来のAIが「データの分類や予測」を得意としていたのに対し、生成AIは「新しいものを創造する」ことができる点が画期的であり、クリエイティブな業務の支援や業務の自動化に大きく貢...