オートマトンの解説(基本情報技術者シラバス用語)
オートマトンとは オートマトン(おーとまとん)とは、あらかじめ決められた「状態」を持ち、外部から「入力(何らかのアクション)」を受けると、そのルールに従って「次の状態」へと遷移(変化)していく、自動的に動作する仕組みや概念モデルのことです。日本語では「自動機械」とも呼ばれます。複雑なコンピュータのプログラムやハードウェアをそのまま設計すると混乱しやすいため、「今どの状態で、何が起きたらどうなるか」...
Django、Python、AWS、Linux、セキュリティ、CVE、基本情報技術者、応用情報技術者、ITパスポートの用語を、図解と実務手順で解説します。個人開発kurutann.comの検証記録や障害対応事例も公開しています。
タグ「基本情報」の記事を表示中× クリア
オートマトンとは オートマトン(おーとまとん)とは、あらかじめ決められた「状態」を持ち、外部から「入力(何らかのアクション)」を受けると、そのルールに従って「次の状態」へと遷移(変化)していく、自動的に動作する仕組みや概念モデルのことです。日本語では「自動機械」とも呼ばれます。複雑なコンピュータのプログラムやハードウェアをそのまま設計すると混乱しやすいため、「今どの状態で、何が起きたらどうなるか」...
形式言語とは 形式言語(けいしきげんご)とは、あらかじめ厳密に定められた文法ルールと記号のみを使って構成される言語のことです。私たちが普段使っている日本語や英語のような「自然言語」は、文脈によって意味が変わったり曖昧さがあったりしますが、形式言語にはそのような曖昧さは一切ありません。ルール通りであれば誰が読んでも、コンピュータが読んでも、ただ1つの意味として正しく解釈されます。プログラミング言語(...
逆ポーランド記法とは 逆ポーランド記法(ぎゃくぽーらんどきほう)とは、数式を書くときに、演算子(+やーなどの記号)を数値の「後ろ」に配置する書き方のことです。「後置記法」とも呼ばれます。私たちが普段使っている「3 + 4」のような書き方は「中置記法」と呼ばれ、演算子が数値の間にあります。これに対して逆ポーランド記法では「3 4 +」と書きます。この書き方の最大のメリットは、カッコ「( )」を使わな...
文字コードとは 文字コード(もじこーど)とは、コンピュータで文字を扱うために、1つひとつの文字に対して割り当てられた固有の「識別番号」のルールのことです。コンピュータは「0」と「1」の数値しか理解できないため、文字を画面に表示したり保存したりするには、すべての文字を数値に置き換える必要があります。この置き換えルールのことを文字コードと呼びます。代表的な規格には、英語圏の基本である「ASCII」、世...
AIとはAI(Artificial Intelligence:人工知能)とは、人間の知的な振る舞い(学習、推論、判断、問題解決など)をコンピュータのソフトウェアやシステムを用いて再現する技術のことです。コンピュータが大量のデータを処理し、パターンを見つけ出すことで、人間のように自ら学んで賢くなっていく仕組みを含みます。近年ではスマートフォンの音声アシスタントや、自動翻訳、画像認識など、日常生活のい...
ディープラーニングとはディープラーニング(Deep Learning:深層学習)とは、人間の脳にある神経細胞(ニューロン)のネットワークを模した「ニューラルネットワーク」を何層にも深く重ねて用いることで、コンピュータに複雑なデータを認識・分析させる技術です。従来の機械学習とは異なり、人間が「どの特徴に注目すべきか」を細かく指示しなくても、コンピュータ自身がデータの中から重要な特徴を自動的に見つけ出...
教師あり学習とは教師あり学習(Supervised Learning)とは、コンピュータによる機械学習の手法の一つで、「問題(入力データ)」と「正解(ラベル)」がセットになった学習データ(教師データ)を事前に大量に与えて学習させる方式です。コンピュータは問題と正解のパターンやルールを学び、それをもとに新しい「問題」だけを与えられたときにも、正しい「正解」を予測・判別できるようになります。画像認識や...
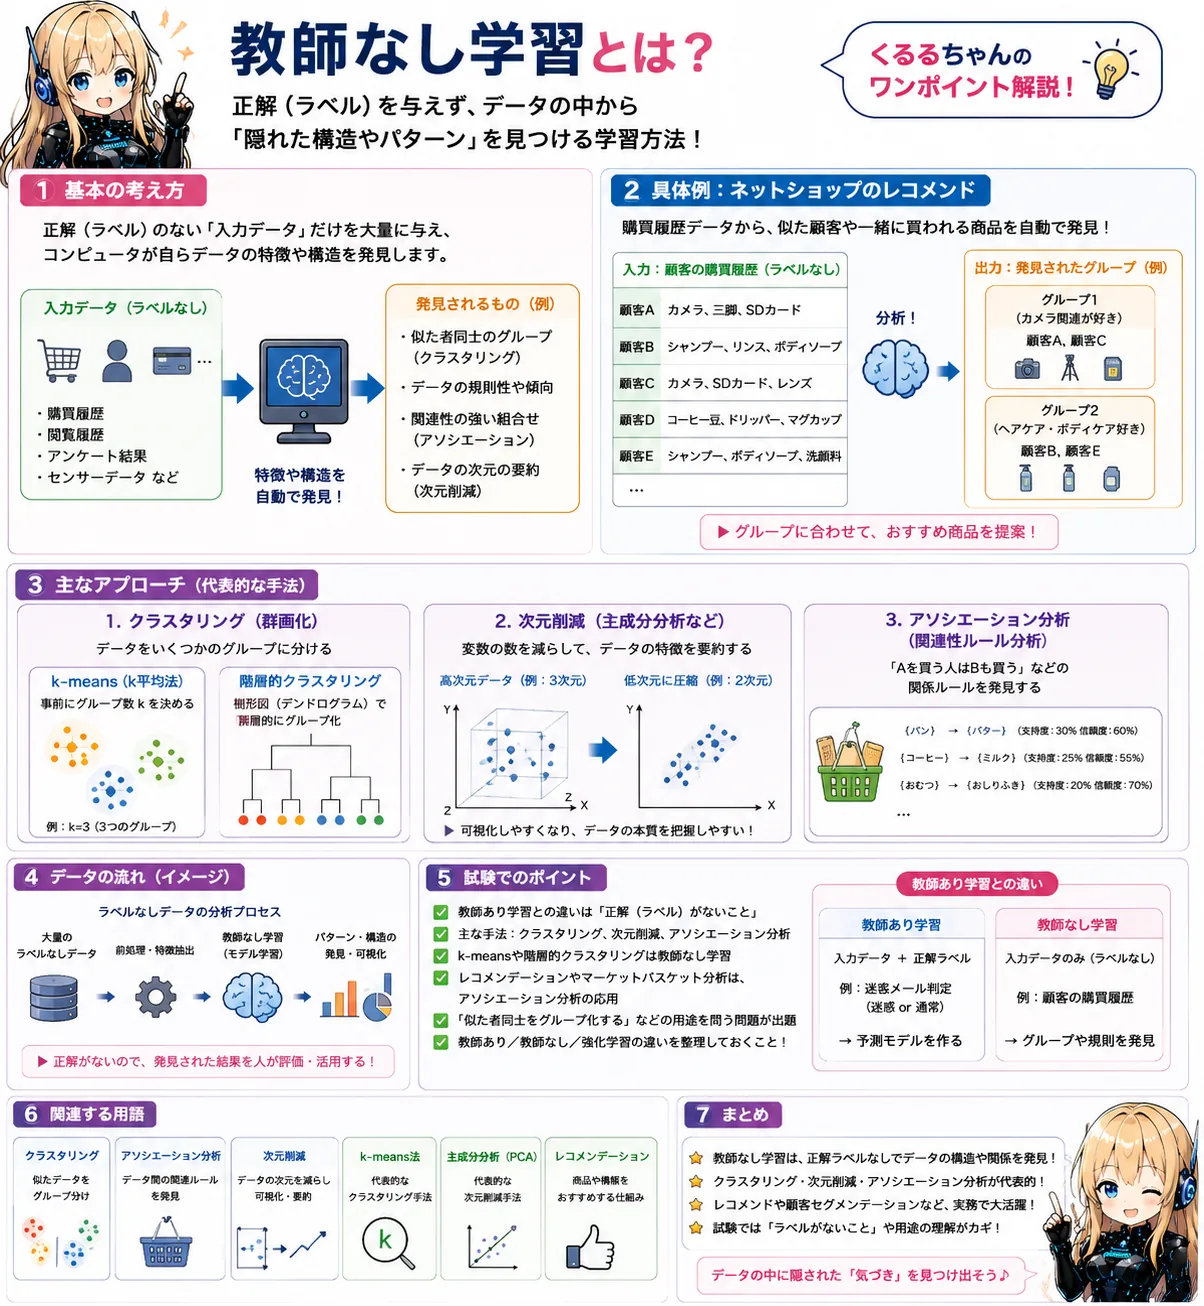
教師なし学習とは教師なし学習(Unsupervised Learning)とは、コンピュータに「正解(ラベル)」を与えず、「問題(入力データ)」だけを大量に与えて学習させる手法です。コンピュータはデータそのものが持つ特徴や構造を自ら分析し、似た者同士をグループに分ける(クラスタリング)ことや、データの規則性を発見することを行います。まだ正解がわかっていないデータの分析や、隠れた関係性を見つけるのに...
強化学習とは強化学習(Reinforcement Learning)とは、コンピュータ(エージェント)が特定の環境のなかで「どのような行動をとるべきか」を試行錯誤を通じて自ら学習する手法です。コンピュータが良い結果を出したときには「報酬(プラスの点数)」を、悪い結果のときには「ペナルティ(マイナスの点数)」を与えることで、得られる報酬の合計が最大になるような最適な行動パターンを自発的に学習していき...
生成AIとは生成AI(Generative AI)とは、大量のデータを学習した人工知能が、人間の指示(プロンプト)に応じて、テキスト、画像、音楽、動画、プログラムのソースコードなど、新しいコンテンツを自動的に作り出す技術です。従来のAIが「データの分類や予測」を得意としていたのに対し、生成AIは「新しいものを創造する」ことができる点が画期的であり、クリエイティブな業務の支援や業務の自動化に大きく貢...
誤り検出とは誤り検出(Error Detection)とは、コンピュータ間でデータを通信したり、ハードディスクなどの記憶媒体にデータを保存したりする際に、ノイズや障害によってデータの内容が途中で書き換わって(破損して)いないかをチェックする技術です。送信側がデータから一定の計算ルールに基づいて「検証用データ」を作り、データと一緒に送ります。受信側でも同じルールで計算し、送られてきた検証用データと一...
誤り訂正とは誤り訂正(Error Correction)とは、コンピュータ間でデータをやり取りしたり、データをストレージに保存したりする際に、ノイズなどによってデータの一部が書き換わって(壊れて)しまった場合、受信側や読み出し側でその誤りを発見し、自動的に正しいデータへ修復(訂正)する技術のことです。誤りを検出するだけでなく、正しい値に直すための追加情報(冗長ビット)をデータと一緒に送ることで実現...
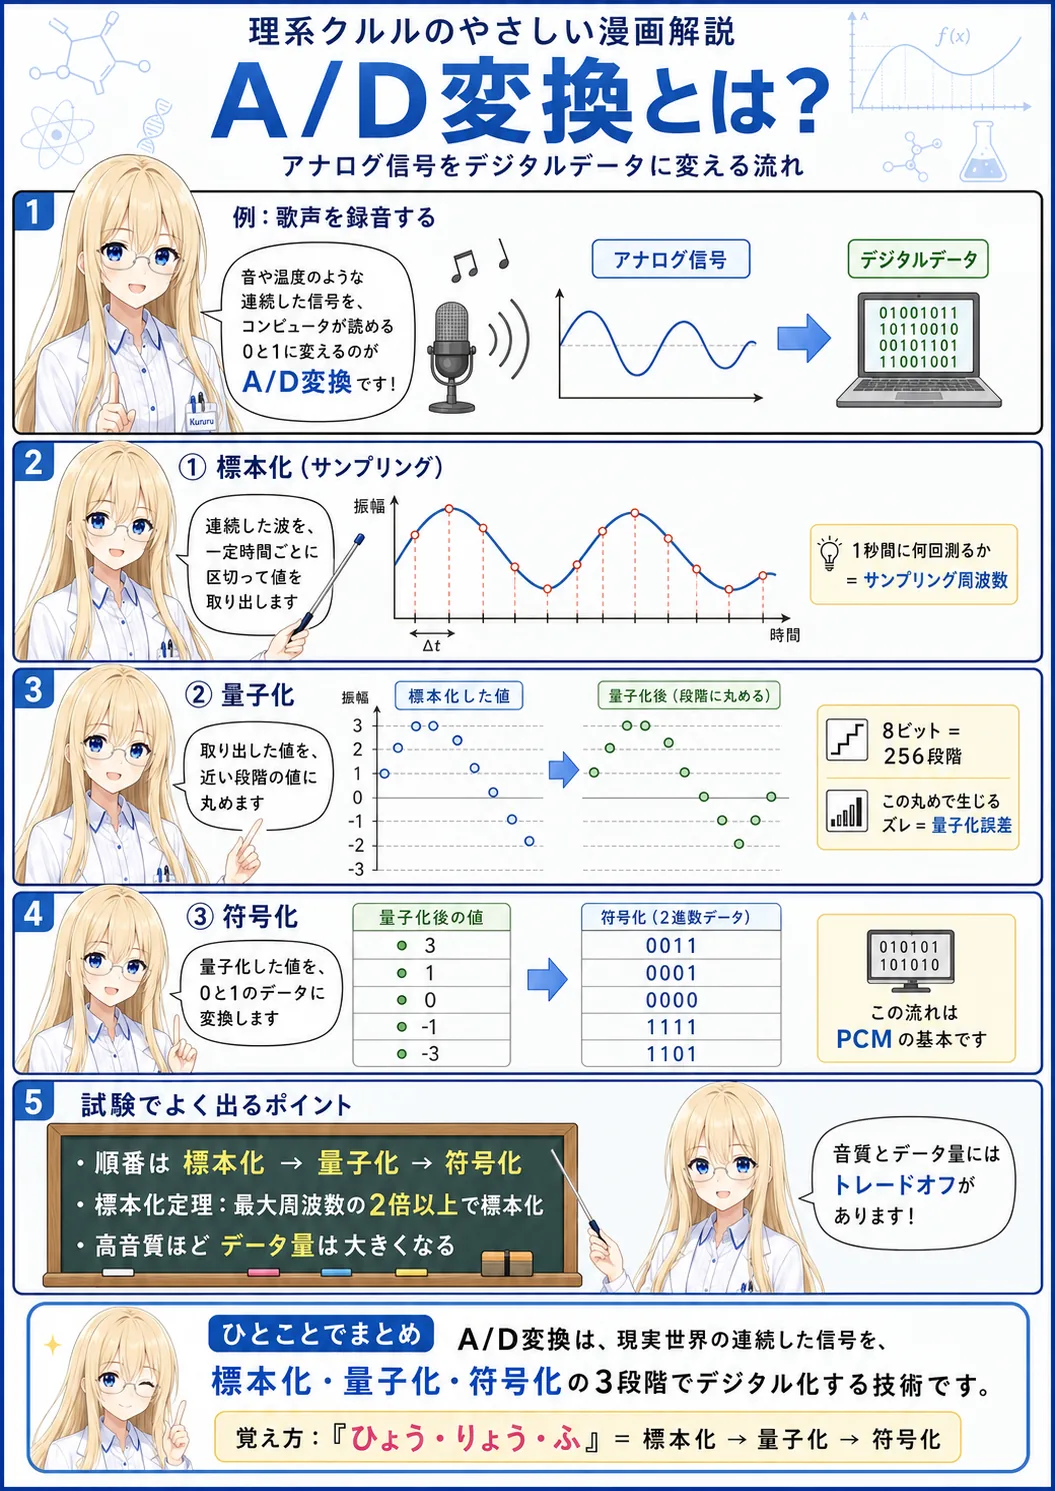
A/D変換とはA/D変換(Analog-to-Digital Conversion:アナログデジタル変換)とは、温度や音、光、電圧などの連続的に変化する「アナログ信号」を、コンピュータが処理できる「0」と「1」の離散的な「デジタルデータ」に変換するプロセスのことです。この変換は、「標本化(サンプリング)」「量子化」「符号化」という3つのステップを経て行われ、センサーから情報を読み取る様々な機器で不...
PWM制御とはPWM制御(Pulse Width Modulation:パルス幅変調)とは、電気回路において電力を細かくコントロールするための技術です。電圧そのものの大きさを変えるのではなく、スイッチの「ON(電気を流す)」と「OFF(電気を止める)」を非常に高速(1秒間に数千〜数万回)で繰り返し、そのONの時間とOFFの時間の比率(デューティ比)を変化させることで、モーターの回転速度やLEDの明...
フィードバック制御とはフィードバック制御(Feedback Control)とは、制御を行う際に対象の「現在の状態(出力)」をセンサーなどで計測し、それを「目標の値」と比較しながら、そのズレを無くすように次の指示(入力)を自動的に調整する制御方式です。「出力を入力に引き戻して反映させる」というループを絶えず繰り返すことで、外からの変化(外乱)があっても目標状態を維持できます。具体例エアコンの温度管...
配列とは配列(Array)とは、複数のデータをコンピュータのメモリ上に一列に並べて管理する最も基本的なデータ構造です。配列内の個々のデータを「要素」と呼び、各要素には「0」から始まる「インデックス(添え字)」という番号が割り当てられます。メモリ上で連続した領域に保存されるため、インデックスを指定するだけで、目的のデータへ瞬時にアクセスできる特徴を持っています。具体例1週間の気温データ(月曜〜日曜ま...
リストとはリスト(連結リスト:Linked List)とは、データそのものと「次のデータがメモリ上のどこにあるかを示す情報(ポインタ)」をセットにした要素(ノード)を、鎖のようにつなぎ合わせて複数のデータを管理するデータ構造です。配列と違い、データがメモリ上でバラバラの位置にあっても問題なく、データの追加や削除をする際に周りのデータをズラす必要がないため、途中の挿入・削除が非常に素早く行える利点が...
スタックとはスタック(Stack)とは、データを一時的に保存するデータ構造の一種で、最初に入れたデータが最後に出てきて、最後に入れたデータが最初に出てくる「後入れ先出し(LIFO:Last In, First Out)」というルールで管理される仕組みです。データを積み上げるイメージで、一番上にデータを追加する操作を「プッシュ(Push)」、一番上からデータを取り出す操作を「ポップ(Pop)」と呼び...
キューとはキュー(Queue)とは、データを一時的に保存するデータ構造の一種で、最初に入れたデータが最初に出ていき、最後に入れたデータは最後に出ていく「先入れ先出し(FIFO:First In, First Out / 待ち行列)」という規則で管理される仕組みです。列の最後尾にデータを追加する操作を「エンキュー」、列の先頭からデータを取り出す操作を「デキュー」と呼びます。具体例プリンターの印刷処理...
木構造とは木構造(Tree Structure)とは、データ同士のつながりを親子関係(階層的)で表現したデータ構造です。樹木を逆さまにしたような形で表され、最上位にある一番大元の要素を「根(ルーツ)」、そこから枝分かれした途中の要素を「節(ノード)」、枝の最下端にある要素を「葉(リーフ)」と呼びます。上から下へ一方通行の親子関係があるのが特徴です。具体例パソコンのフォルダ(ディレクトリ)管理がもっ...
二分探索木とは二分探索木(Binary Search Tree)とは、木構造の中でも「各ノード(要素)が持つ子供は最大で2つまで(二分木)」であり、かつデータが一定の配置ルールに従って整理された構造です。そのルールとは、「あるノードを基準として、その左側には親より小さい値、右側には親より大きい値のデータだけを置く」というものです。この配置により、目的のデータを検索するスピードが非常に早くなります。...
ヒープとはヒープ(Heap)とは、木構造(特に完全二分木)を利用したデータ構造の一種で、「親ノードの値が、子ノードの値よりも常に大きい(または常に小さい)」という親子関係のルールを木全体で保っている状態のことです。このルールを守ることにより、木の一番上(根)には常に「最大値」または「最小値」のデータが配置されることになります。最大(小)値を素早く取り出す用途に適しています。具体例「優先度付きのタス...
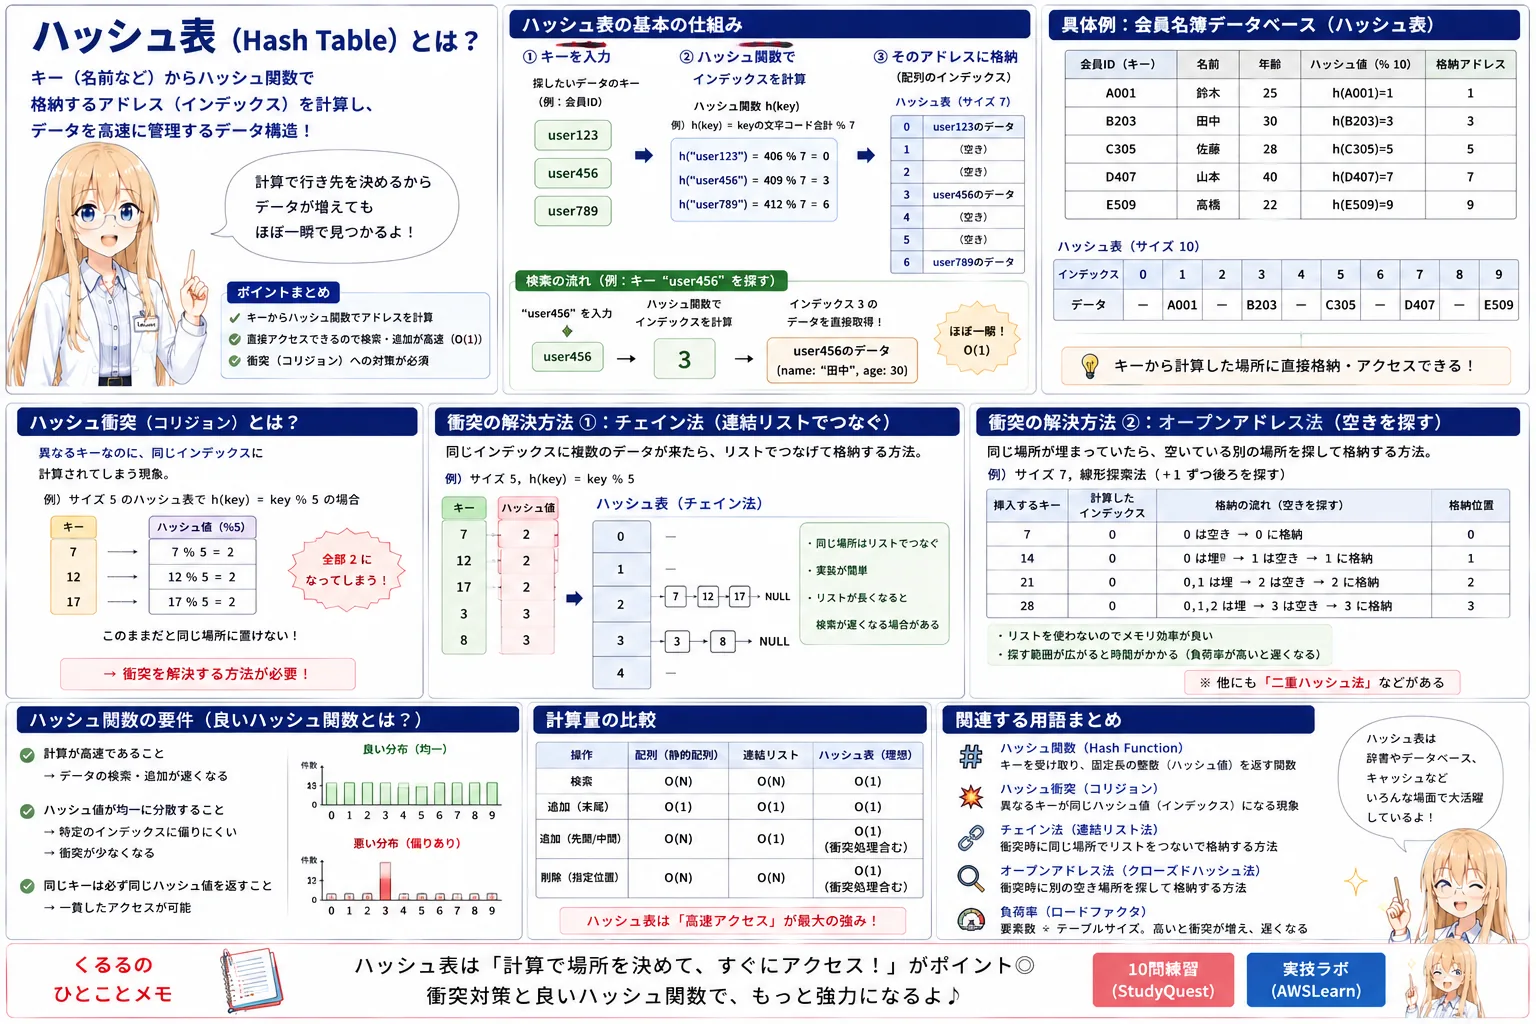
ハッシュ表とはハッシュ表(Hash Table)とは、「ハッシュ関数」と呼ばれる特別な計算式を用いて、探したいデータの「キー(名前など)」から、そのデータが格納されるメモリ上の「アドレス(インデックス番号)」を直接算出して管理するデータ構造です。最初からデータの場所が計算で分かるため、データ数が膨大になっても、データの追加や検索をほぼ一瞬(一定時間)で行うことができます。具体例会員名簿データベース...
グラフとはグラフ(Graph)とは、データ同士の複雑な「つながりや関係性」を表現するためのデータ構造です。個々のデータを「頂点(ノード)」、つながりを示す線を「辺(エッジ)」と呼びます。辺に矢印(向き)があるものを「有向グラフ」と呼び、一方通行のルートなどを表します。向きがないものは「無向グラフ」と呼び、双方向のつながりを表します。具体例電車の路線図が代表的な例です。各駅が「頂点」、駅間をつなぐ路...