計算量のオーダー表記の解説(応用情報技術者シラバス用語)
計算量のオーダー表記とは計算量のオーダー表記(O記法/オー記法)とは、アルゴリズム(問題を解く手順)の効率の良さを評価するために、処理を実行するのに必要な手間や時間が、処理するデータの量(N)が増えたときにどれくらい増加するかを大まかに表す記法です。コンピュータの性能や実行環境に関わらず、アルゴリズムそのものの純粋な「賢さ」を測るために使われます。データの数Nに対して、処理回数が比例して増える場合...
Django、Python、AWS、Linux、セキュリティ、CVE、基本情報技術者、応用情報技術者、ITパスポートの用語を、図解と実務手順で解説します。個人開発kurutann.comの検証記録や障害対応事例も公開しています。
タグ「データ構造」の記事を表示中× クリア
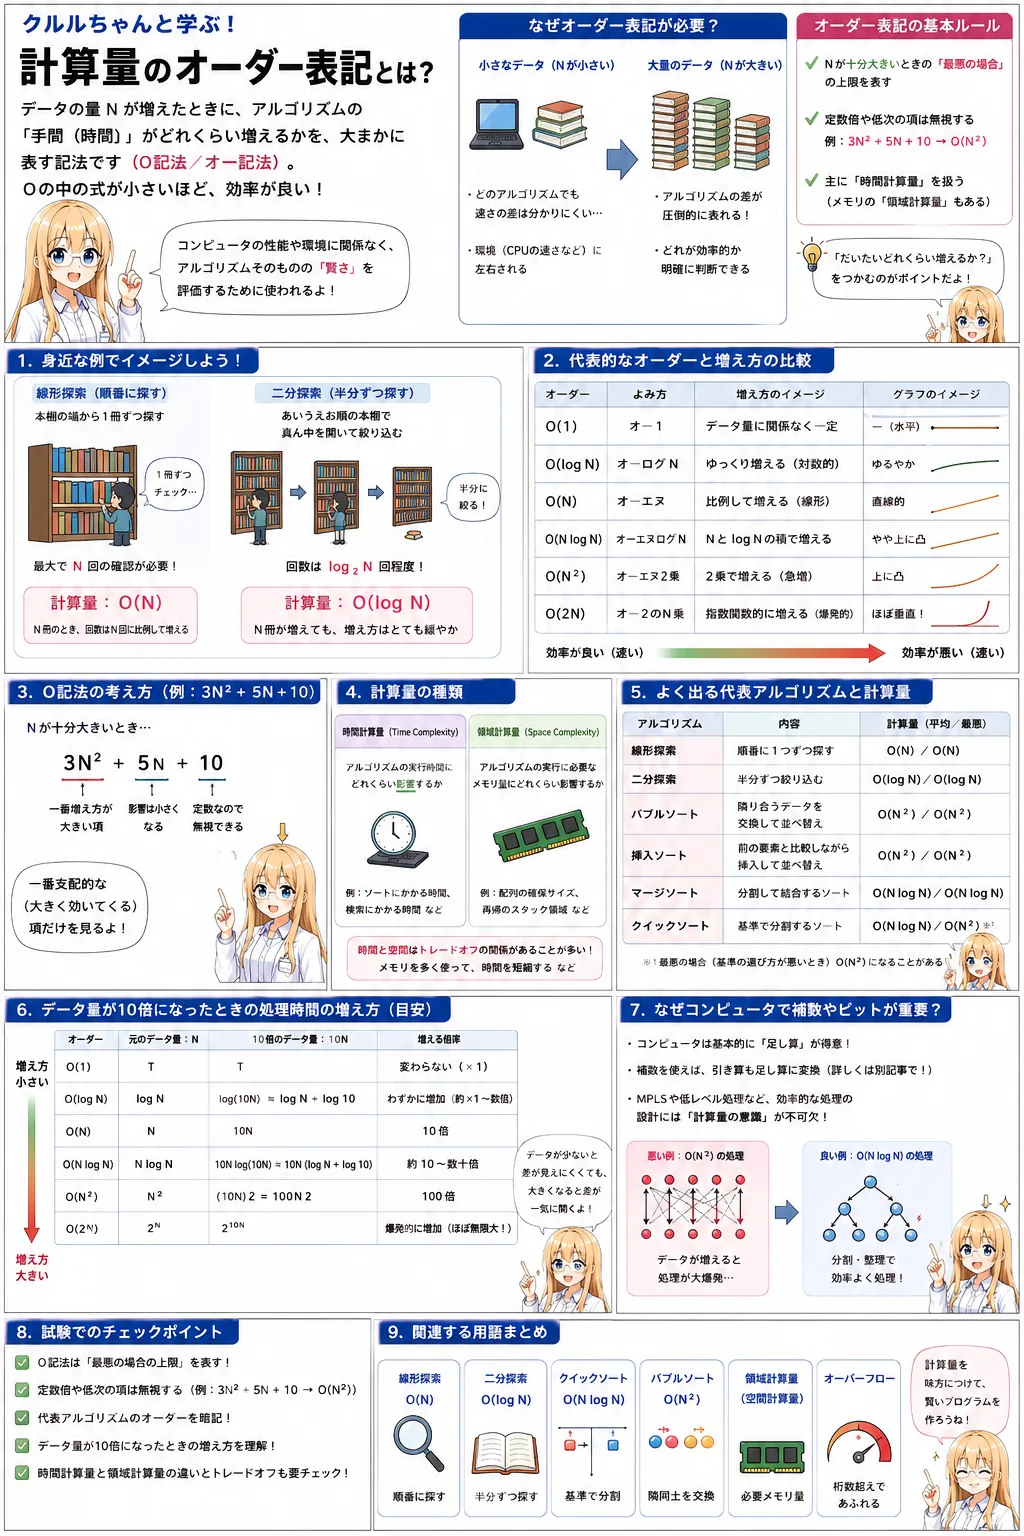
計算量のオーダー表記とは計算量のオーダー表記(O記法/オー記法)とは、アルゴリズム(問題を解く手順)の効率の良さを評価するために、処理を実行するのに必要な手間や時間が、処理するデータの量(N)が増えたときにどれくらい増加するかを大まかに表す記法です。コンピュータの性能や実行環境に関わらず、アルゴリズムそのものの純粋な「賢さ」を測るために使われます。データの数Nに対して、処理回数が比例して増える場合...
動的計画法とは動的計画法(DP:Dynamic Programming)とは、大きな問題を解くために、それを小さな問題に分割して解き、その「途中の計算結果」をメモリなどに記録(メモ化)しておき、後で同じ計算が必要になったときに再利用するアルゴリズムの設計手法です。同じ計算を何度も繰り返す無駄を省くことで、処理時間を劇的に短縮することができます。通常、再帰呼び出しと呼ばれる手法などでは、過去に解いた...
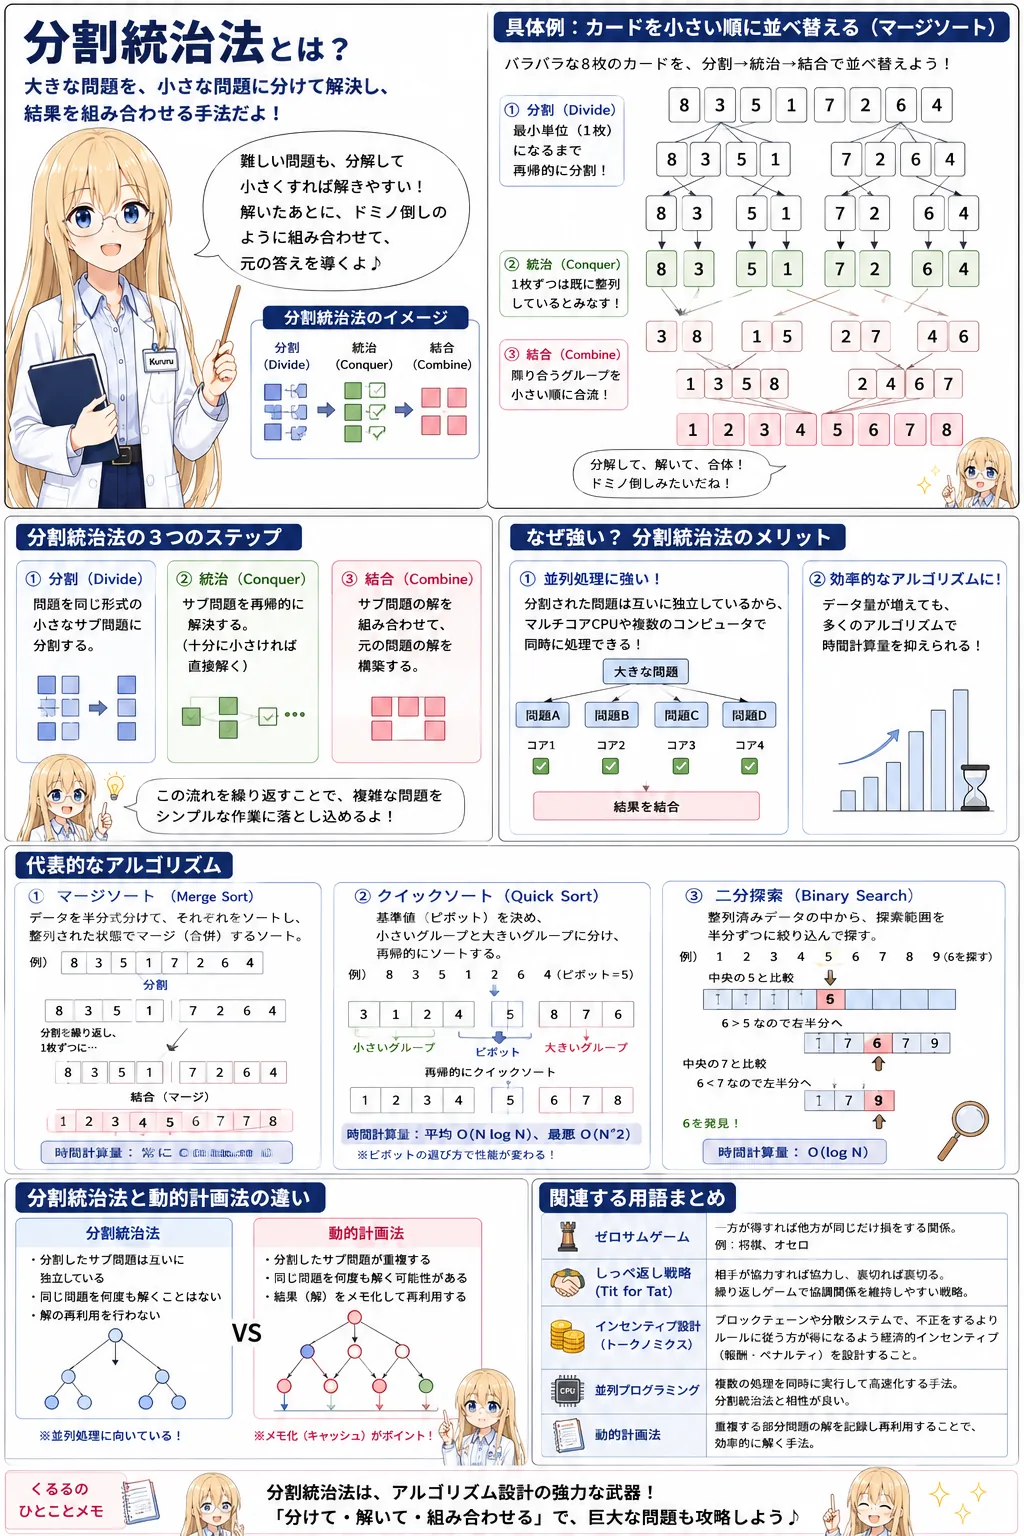
分割統治法とは分割統治法とは、そのままでは解決するのが難しい大きな問題を、いくつかの「扱いやすい小さな問題」に細かく分割し、それぞれの小さな問題を個別に解決(統治)してから、最後にその結果を組み合わせて元の大きな問題の答えを導き出す手法です。このアプローチはアルゴリズム設計の基本であり、特にデータを並び替える「ソート」や、データを検索する処理でよく使われます。問題を細かく分割するプロセスは、これ以...
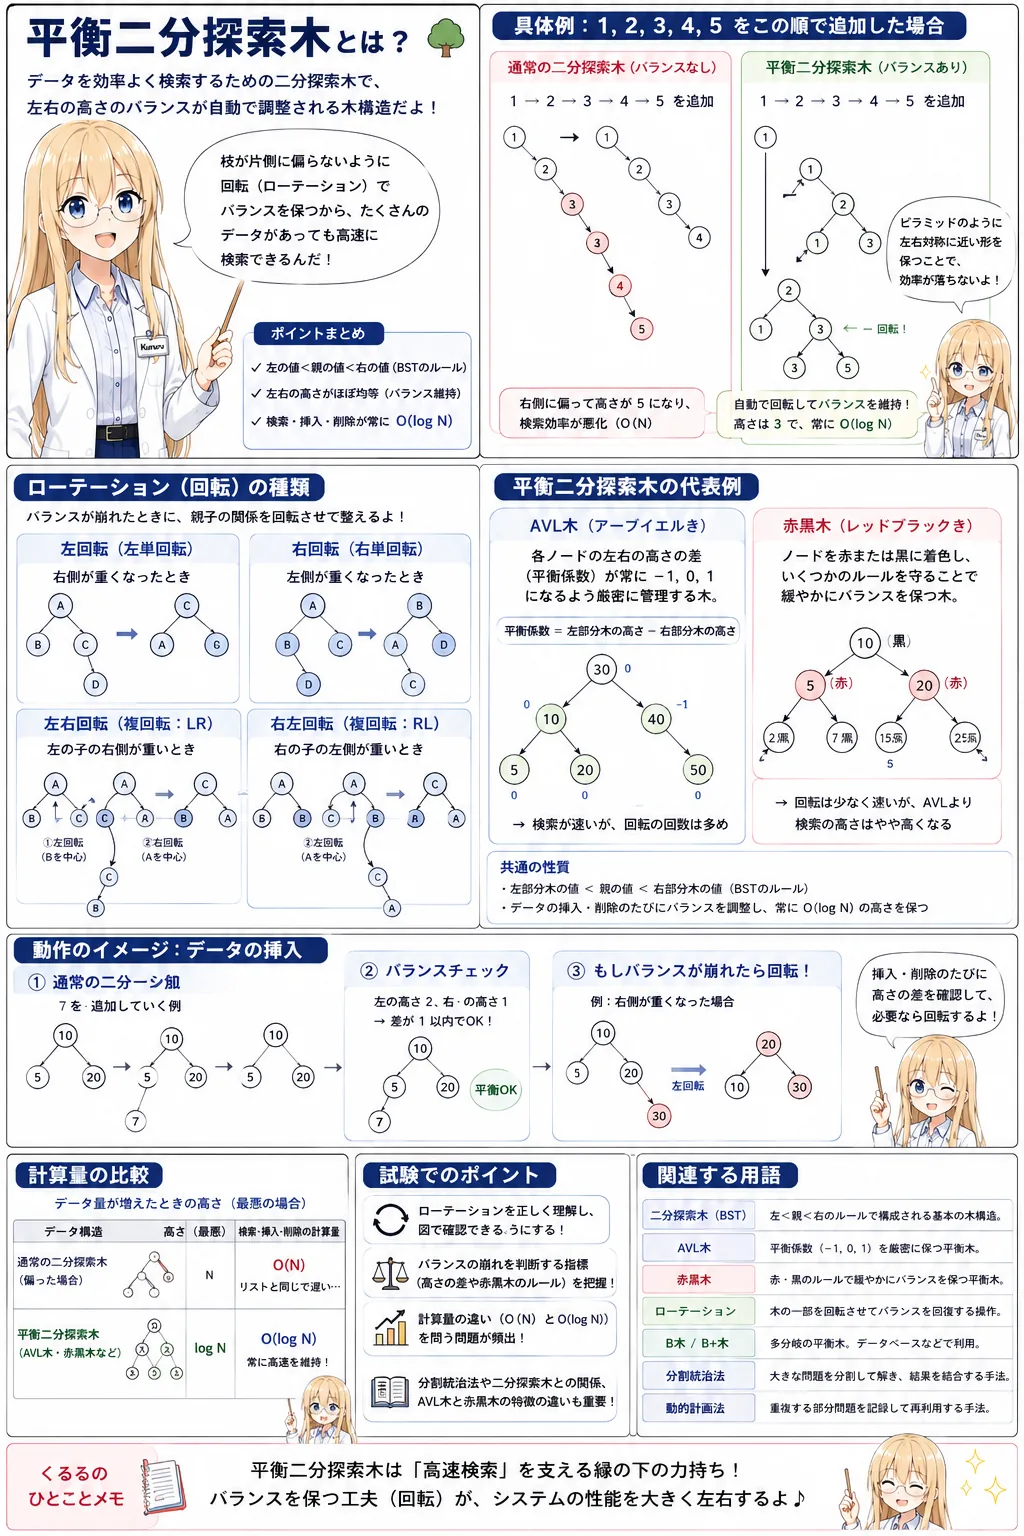
平衡二分探索木とは平衡二分探索木とは、データを効率よく検索するための「ツリー構造(木構造)」の一種で、左右の枝のバランス(高さ)が常にほぼ均等に保たれるように自動的に調整されるデータ構造です。「AVL木」や「赤黒木」などが有名です。通常の二分探索木は、データを追加していく順番によっては、枝が片側だけに偏って長く伸びてしまい、データを検索する効率が著しく低下して単なるリストのようになってしまう欠点が...
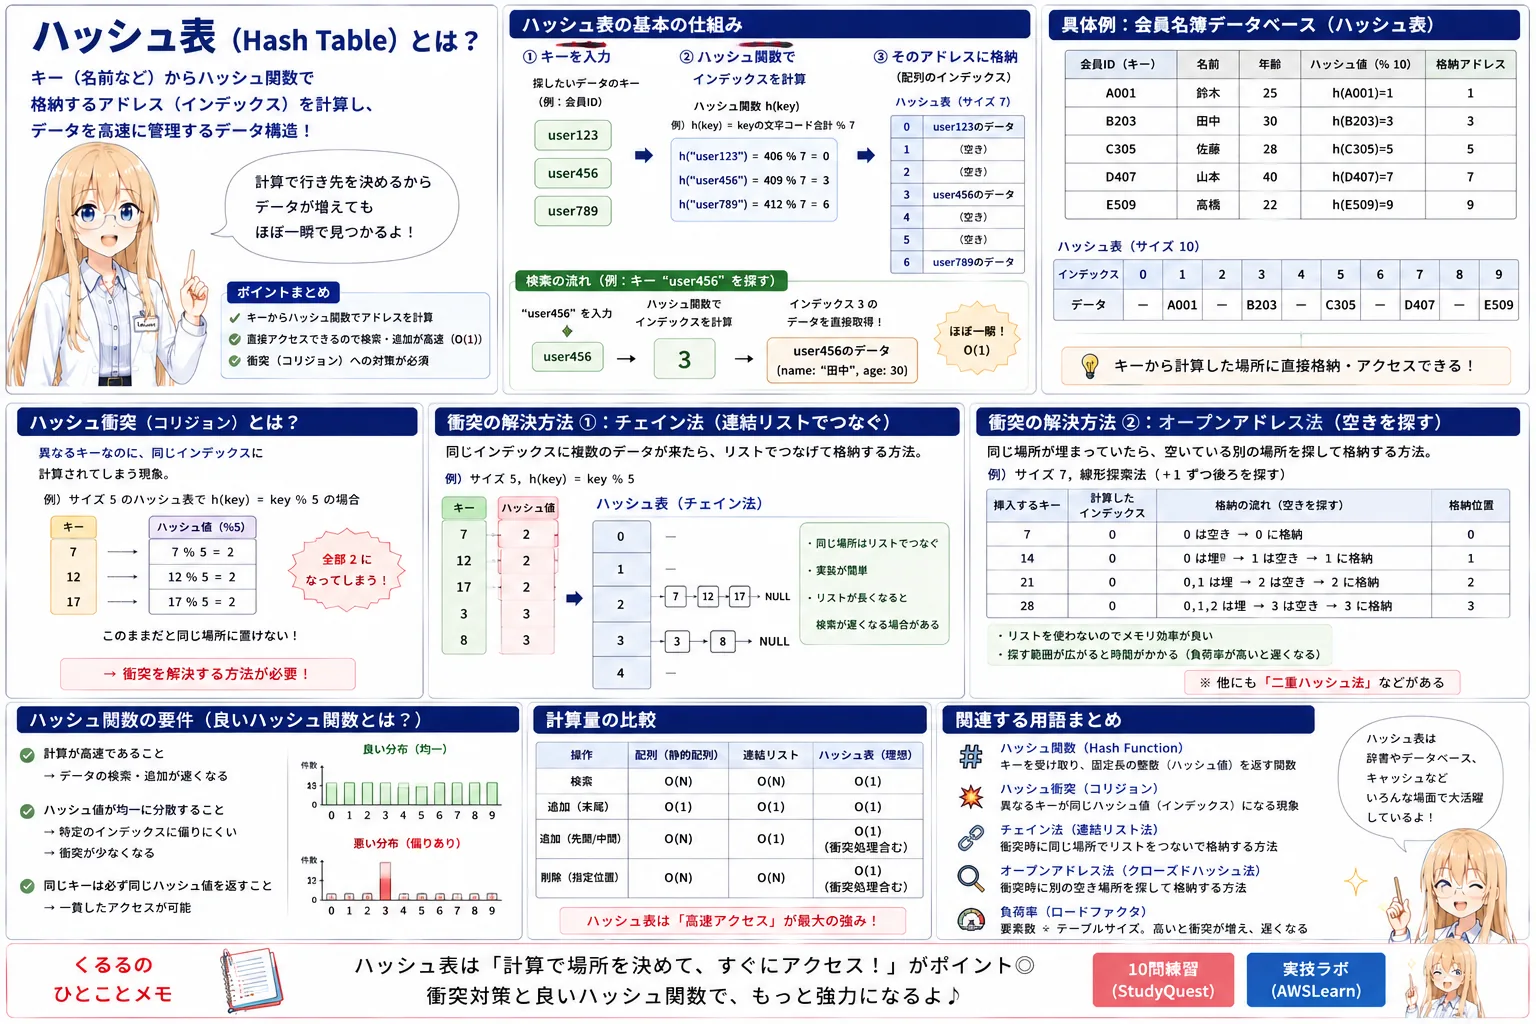
ハッシュ衝突とはハッシュ衝突とは、異なるデータ(入力値)をハッシュ関数と呼ばれる計算式に通した結果、偶然にも「全く同じハッシュ値(出力されるコード)」が生成されてしまう現象のことです。ハッシュ関数は、どんな長さのデータからも、固定された短い長さ of ランダムな値(ハッシュ値)を作り出す便利な仕組みです。しかし、入力できるデータのパターンは無限にあるのに対し、出力されるハッシュ値のパターンは有限で...
配列とは配列(Array)とは、複数のデータをコンピュータのメモリ上に一列に並べて管理する最も基本的なデータ構造です。配列内の個々のデータを「要素」と呼び、各要素には「0」から始まる「インデックス(添え字)」という番号が割り当てられます。メモリ上で連続した領域に保存されるため、インデックスを指定するだけで、目的のデータへ瞬時にアクセスできる特徴を持っています。具体例1週間の気温データ(月曜〜日曜ま...
リストとはリスト(連結リスト:Linked List)とは、データそのものと「次のデータがメモリ上のどこにあるかを示す情報(ポインタ)」をセットにした要素(ノード)を、鎖のようにつなぎ合わせて複数のデータを管理するデータ構造です。配列と違い、データがメモリ上でバラバラの位置にあっても問題なく、データの追加や削除をする際に周りのデータをズラす必要がないため、途中の挿入・削除が非常に素早く行える利点が...
スタックとはスタック(Stack)とは、データを一時的に保存するデータ構造の一種で、最初に入れたデータが最後に出てきて、最後に入れたデータが最初に出てくる「後入れ先出し(LIFO:Last In, First Out)」というルールで管理される仕組みです。データを積み上げるイメージで、一番上にデータを追加する操作を「プッシュ(Push)」、一番上からデータを取り出す操作を「ポップ(Pop)」と呼び...
キューとはキュー(Queue)とは、データを一時的に保存するデータ構造の一種で、最初に入れたデータが最初に出ていき、最後に入れたデータは最後に出ていく「先入れ先出し(FIFO:First In, First Out / 待ち行列)」という規則で管理される仕組みです。列の最後尾にデータを追加する操作を「エンキュー」、列の先頭からデータを取り出す操作を「デキュー」と呼びます。具体例プリンターの印刷処理...
木構造とは木構造(Tree Structure)とは、データ同士のつながりを親子関係(階層的)で表現したデータ構造です。樹木を逆さまにしたような形で表され、最上位にある一番大元の要素を「根(ルーツ)」、そこから枝分かれした途中の要素を「節(ノード)」、枝の最下端にある要素を「葉(リーフ)」と呼びます。上から下へ一方通行の親子関係があるのが特徴です。具体例パソコンのフォルダ(ディレクトリ)管理がもっ...
二分探索木とは二分探索木(Binary Search Tree)とは、木構造の中でも「各ノード(要素)が持つ子供は最大で2つまで(二分木)」であり、かつデータが一定の配置ルールに従って整理された構造です。そのルールとは、「あるノードを基準として、その左側には親より小さい値、右側には親より大きい値のデータだけを置く」というものです。この配置により、目的のデータを検索するスピードが非常に早くなります。...
ヒープとはヒープ(Heap)とは、木構造(特に完全二分木)を利用したデータ構造の一種で、「親ノードの値が、子ノードの値よりも常に大きい(または常に小さい)」という親子関係のルールを木全体で保っている状態のことです。このルールを守ることにより、木の一番上(根)には常に「最大値」または「最小値」のデータが配置されることになります。最大(小)値を素早く取り出す用途に適しています。具体例「優先度付きのタス...
ハッシュ表とはハッシュ表(Hash Table)とは、「ハッシュ関数」と呼ばれる特別な計算式を用いて、探したいデータの「キー(名前など)」から、そのデータが格納されるメモリ上の「アドレス(インデックス番号)」を直接算出して管理するデータ構造です。最初からデータの場所が計算で分かるため、データ数が膨大になっても、データの追加や検索をほぼ一瞬(一定時間)で行うことができます。具体例会員名簿データベース...
グラフとはグラフ(Graph)とは、データ同士の複雑な「つながりや関係性」を表現するためのデータ構造です。個々のデータを「頂点(ノード)」、つながりを示す線を「辺(エッジ)」と呼びます。辺に矢印(向き)があるものを「有向グラフ」と呼び、一方通行のルートなどを表します。向きがないものは「無向グラフ」と呼び、双方向のつながりを表します。具体例電車の路線図が代表的な例です。各駅が「頂点」、駅間をつなぐ路...